精华速览
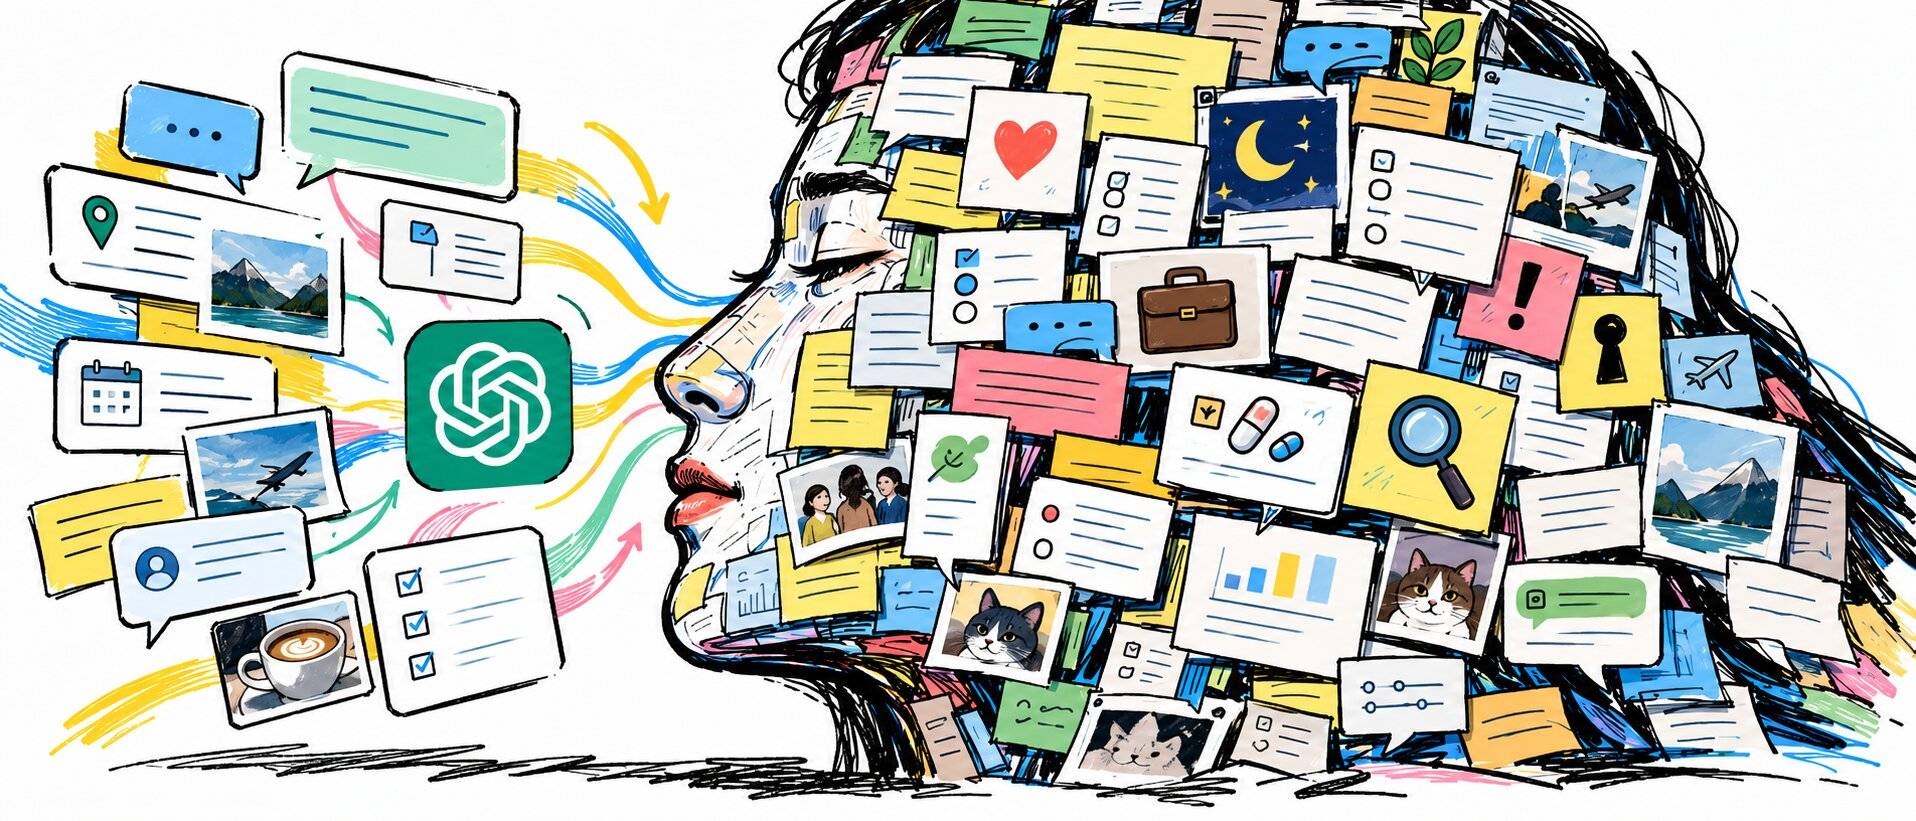
一项被ACM Web Conference 2026接收的论文《The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT》首次从外部系统拆解了ChatGPT的记忆机制。研究者利用GDPR数据访问权,获取80名真实用户的1058段对话、22971轮交互和2050条记忆条目。研究发现,仅4.1%的记忆由用户明确要求写入,95.9%由ChatGPT自主判断后单方面存储;28%的记忆包含GDPR定义的个人数据,7%含健康等特殊类别数据,52%包含对用户心理状态的推断。研究还构建了可预测记忆提取过程的复刻模型,并开发Attribution Shield工具,通过改写查询降低个人归因,同时保持回答实用性。
要点透视
- 研究样本覆盖80名真实用户,包含1058段对话、22971轮交互和2050条记忆条目,数据通过GDPR赋予的用户数据访问权获取。
- 在2050条记忆条目中,仅84条(4.1%)由用户通过“记住”“保存”等触发词明确要求写入,其余95.9%由ChatGPT自主判断后单方面存储。
- 28%的记忆包含GDPR定义的个人数据,姓名出现在41%的条目中;7%的记忆包含特殊类别数据,其中健康信息占61%;91%的参与者被存储了个人数据,35%被存储了健康相关信息。
- 52%的记忆包含对用户心理状态的推断,其中欲望类占73%、意图类占16%,情绪和感知等瞬时状态仅占约两成。
- 记忆溯源验证显示,84%的记忆能在用户完整对话历史中找到直接文本依据,77%被评定为“直接陈述”或“转述总结”,明确“无依据或矛盾”的仅占4%。
- 研究者用Qwen2.5-32B、Gemma3-27B、GPT-OSS-20B三个开源模型复刻ChatGPT的记忆提取过程,预测记忆与真实记忆的语义相似度约为60%至70%。
- 基于复刻模型搭建的Attribution Shield工具,在评测中使94%至100%的改写查询显著降低个人归因,同时87%至91%的改写保持了回答实用度不变。
- 若ChatGPT记录全部对话内容,敏感信息占比预计从28%升至31%至35%,心理推断占比从52%升至55%至59%。
文章拆解
这项研究之所以值得关注,在于它第一次用可验证的外部数据回答了“AI记忆黑箱里到底装了什么”。过去用户对ChatGPT记忆的认知主要来自OpenAI的官方文档,文档强调用户可查看、修改、删除记忆,且系统不会主动记录敏感信息。但论文数据显示,记忆形成的主导权实际在系统一侧:用户只能通过“说什么”间接影响“记什么”,96%的记忆由模型自主判断写入。这并不直接违反OpenAI公布的政策,因为文档确实允许ChatGPT保存其认为“有用”的信息,但用户参与感与实际控制力之间的落差构成了核心矛盾。
更深层的变化在于记忆内容的性质。传统平台刻画的是行为轮廓,即用户做了什么;ChatGPT的记忆则大量涉及对用户人格特征的推断,欲望和意图合计占心理状态推断的近九成。一条“某用户对失败有恐惧,尤其涉及重大职业决策”式的记忆,已经超出事实记录范畴,进入对“用户是谁”的判断。研究同时显示这类推断大多有对话依据,84%可溯源,但“大体忠实”不等于“没有偏差”,4%的无依据或矛盾条目在长期对话中可能被反复强化,形成对用户的错误画像并持续影响后续交互。
从行业影响看,记忆机制正成为对话式AI的标配能力,Gemini、Claude等产品均已引入类似功能。这项研究提示,隐私风险不只来自数据泄露,还来自系统对用户特征的自主归纳与长期留存。研究者提出的技术路径表明隐私保护与对话质量并非非此即彼:通过预判查询会触发哪些敏感记忆并做去身份化改写,可以在降低个人归因的同时保持回答实用性。不过该工具基于开源模型复刻,与ChatGPT真实记忆提取过程存在语义相似度约60%至70%的差距,实际部署效果尚待确认。
对普通用户而言,当下可操作的变量是主动审计已有记忆。用户可在ChatGPT设置中查看个性化记忆,识别过时、错误或不愿保留的条目。论文附带的审计提示词要求模型区分已存储信息与新生成推断、标注置信度并说明信息来源,这本身也是对AI透明度的一次压力测试。潜在风险在于,随着记忆条目累积和模型推断能力增强,用户对自身“算法画像”的核查成本会持续上升,而监管层面如何界定AI自主推断内容的归属与删除权,目前尚待确认。
暂无评论。